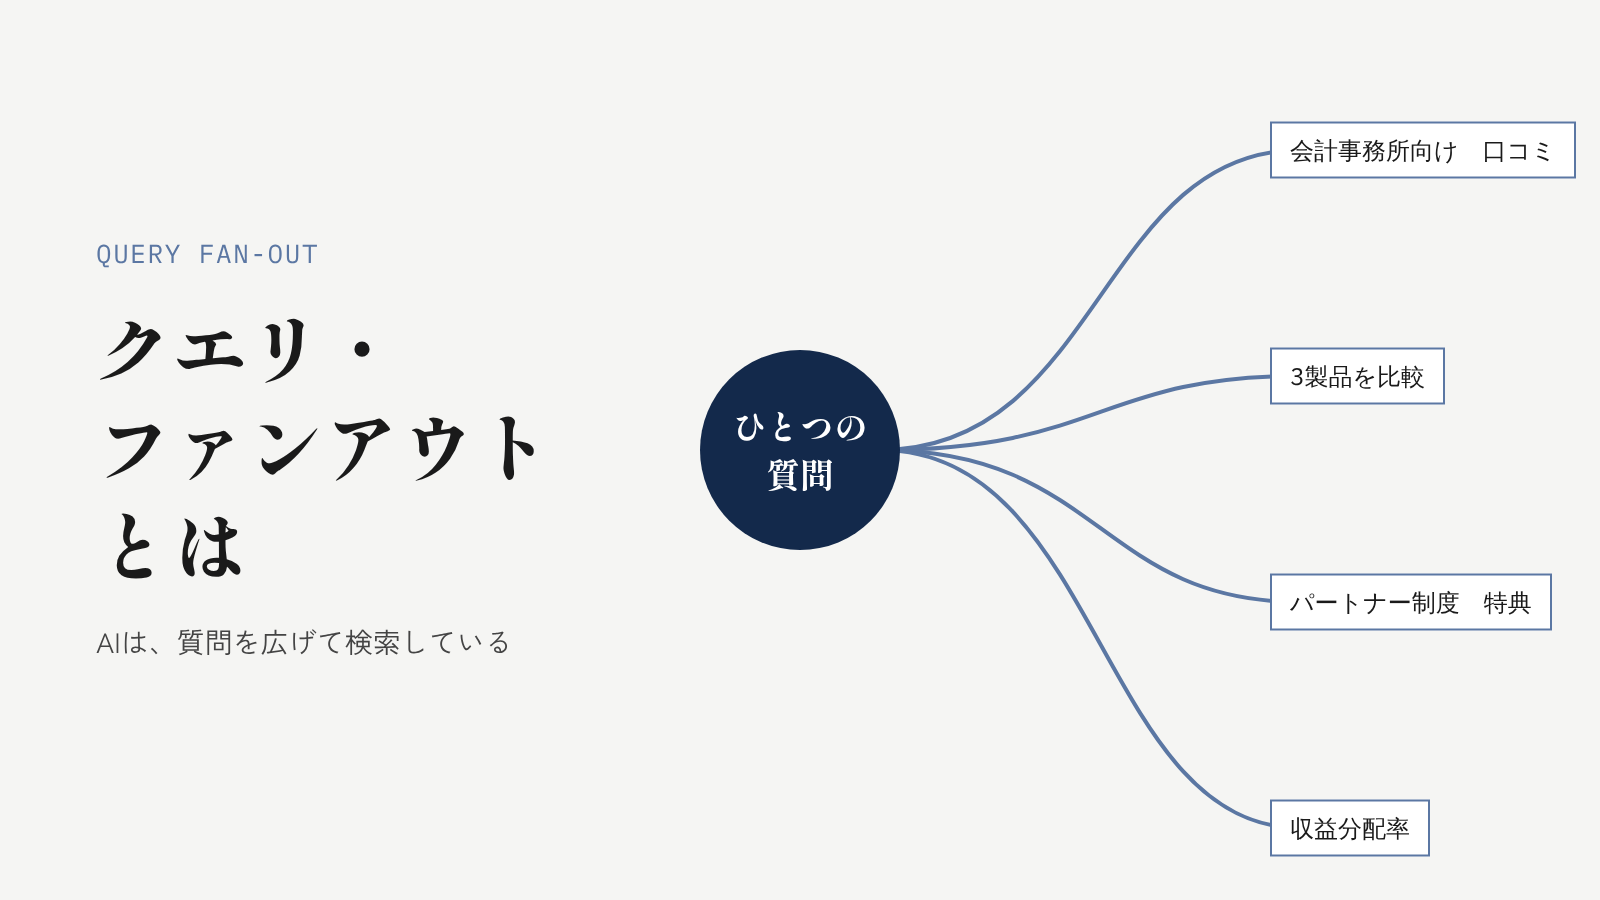
- クエリ・ファンアウトとは、AIがひとつの質問を関連するいくつもの検索に広げて実行し、その結果から答えを組み立てる仕組み。AIが検索するのは、学習データだけでは答えられないとき
- AIはGoogleやBingなどの検索結果を読んでいる。引用されたページの多くは、元の質問より、AIが広げた検索のほうで上位にいる
- AIが作る検索の95%は検索ボリュームがゼロ。具体的な問いに正面から答えるページを持ち、いくつもの検索で拾われることが効く
こんにちは、アースダイバー代表の佐藤です。AIが広がって、ウェブマーケティングは取るべき戦略も、実行のやり方も変わりました。アースダイバーは、その新しい前提で戦略を考え、実行する仕組みまでつくる会社です(ご相談はこちら)。
最近、「クエリ・ファンアウト」という言葉をよく聞くようになりました。ChatGPTやGeminiが、質問に答えるまでの裏側で何をしているのか。それを表す言葉です。AI検索対策(AIO・LLMO対策)の話はたくさん出ていますが、この仕組みを知らないまま対策を考えると、たぶん的を外します。今回は対策の話は最小限にして、仕組みのほうをじっくり書きます。
目次
クエリ・ファンアウトとは
クエリ・ファンアウトとは、AIがひとつの質問を、関連するいくつもの検索に広げて実行し、その結果を読み合わせて答えを組み立てる仕組みのことです。ファンアウトは「扇状に広がる」という意味です。
Googleは、AIモードの説明の中で、この仕組みを「質問をサブトピックに分け、ユーザーに代わって多数の検索を同時に実行する」と書いています(Google)。ChatGPTも同じような動きをしていて、OpenAIのヘルプには、質問をひとつ以上の検索語に書き換えて検索し、最初の結果を見たうえで、さらに絞り込んだ検索を追加することがある、と書かれています(OpenAI)。
実際の例を見てみます。米国のSeer Interactiveが、Gemini 3に「簿記担当者にいちばんいい給与計算ソフトは?」と英語で聞いたところ、Geminiが裏側で作った検索は16本でした。そのうち、調査記事で公開されている4本がこれです(Seer Interactive)。
面白いのは、質問に書いていない「口コミ」や「パートナー制度」まで広がっているところです。しかも、検索の時点でADPやGustoといった製品名がもう入っている。給与計算ソフトを選ぶ人が次に気にしそうなことを、AIが先回りして調べているわけです。
そもそも、AIはいつ検索するのか
先にひとつ、大事な前提があります。AIは、いつも検索しているわけではありません。
AIの答え方は、大きく2つあります。ひとつは、学習したデータの中にある知識だけで答えるやり方。もうひとつは、検索して調べてから答えるやり方です。クエリ・ファンアウトが起きるのは、後者のときです。学習データから答える側の話も奥が深いのですが、今回はそこには踏み込みません。
検索するかどうかは、AI自身が決めています。Googleは開発者向けの説明で、Geminiは質問を分析し、Google検索で答えが良くなるかどうかを判断したうえで、必要なら検索語を作って実行する、と書いています(Google)。
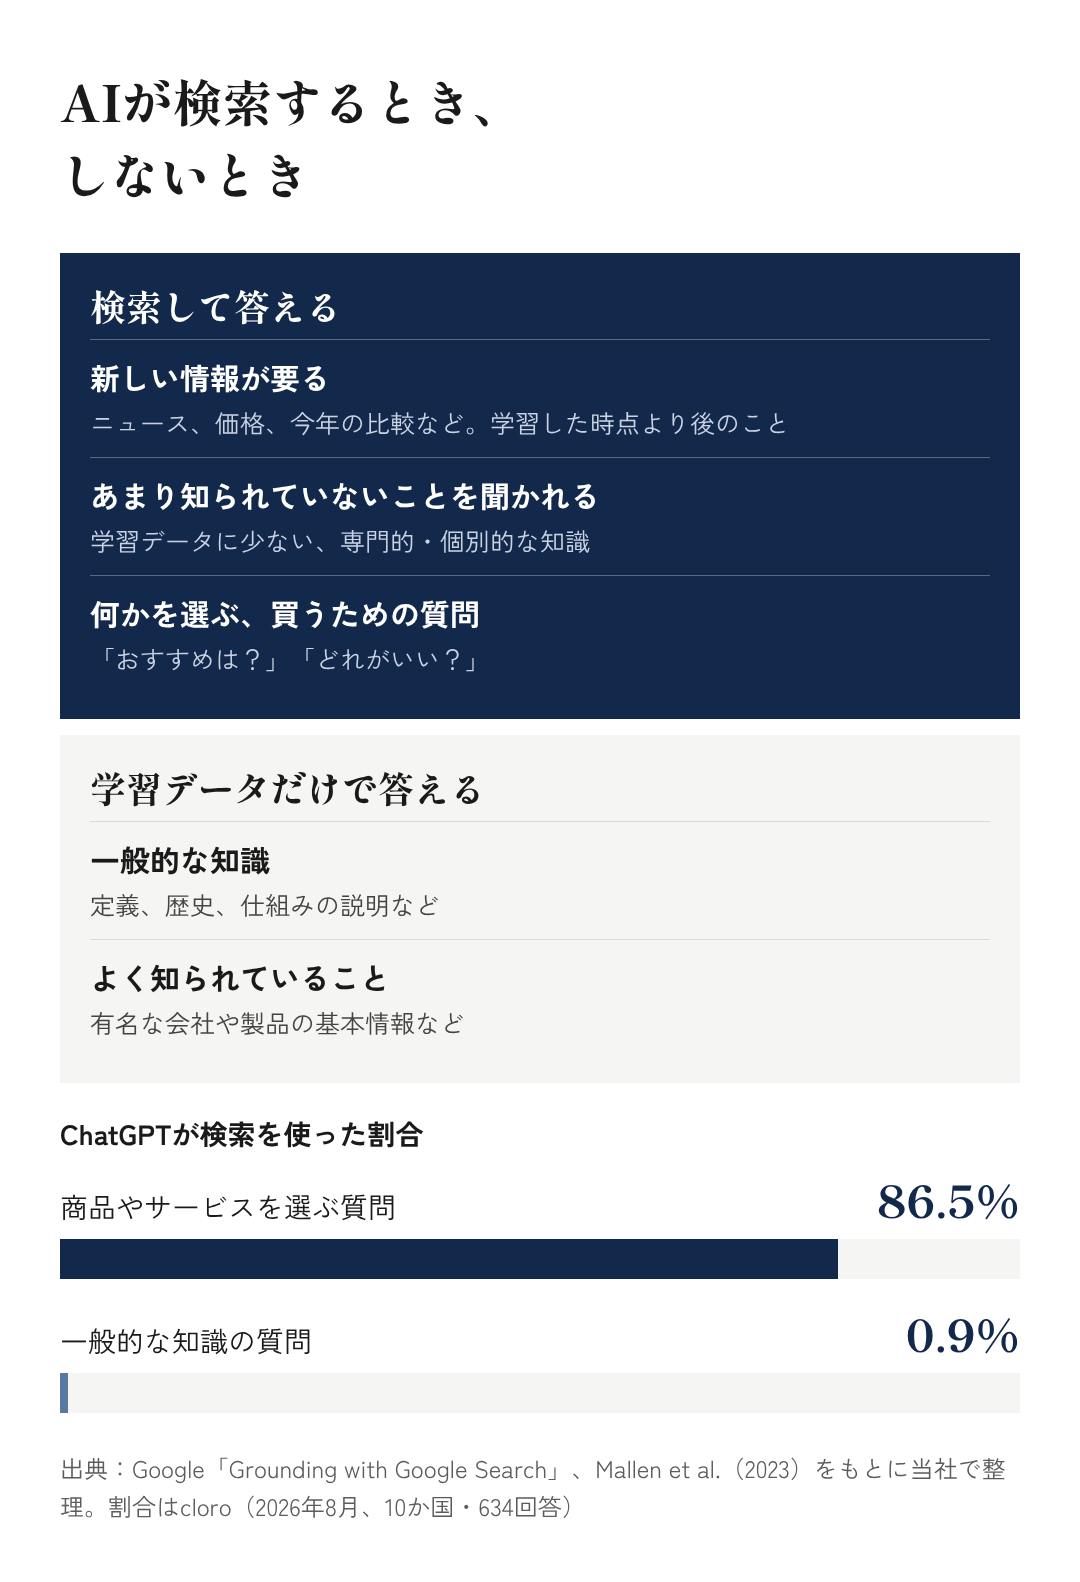
検索が起きやすいのは、学習データだけでは答えられないときです。ひとつは、新しい情報が要るとき。学習した時点より後のことは、調べないとわかりません。もうひとつは、あまり知られていないことを聞かれたとき。言語モデルは、よく知られた事実はよく覚えている一方、知名度の低い事実ほど覚えておらず、検索で補うと正確さが大きく上がることが研究で示されています(Mallen et al., 2023)。
質問の種類による差は、かなりはっきりしています。cloroが10か国でChatGPTを調べたところ、商品やサービスを選ぶ質問では86.5%で検索が使われ、定義や歴史のような一般的な知識の質問では0.9%でした(cloro)。
「おすすめの会社は?」「どのツールがいい?」という質問は、ほぼ検索される側に入ります。 企業にとってクエリ・ファンアウトが関係あるのは、まさにここです。
AIが検索してから答えるまでの4つの段階
検索すると決めたあと、AIが答えを出すまでの流れは、4つの段階に分けられます。
1. 質問の意図を読む
まず、質問の裏にある意図を読みます。このとき、質問の文面だけを見ているわけではありません。Googleが出願している特許(「Search with stateful chat」、US20240289407A1)では、それまでの会話の流れ、場所、時刻、検索の履歴といった文脈も使うことが書かれています(解説記事)。同じ質問でも、人や聞くタイミングによって広がり方が変わりうる、ということです。
2. 関連する検索を作る
次に、元の質問に関連する検索を、AI自身が作ります。同じ特許では、これを「合成クエリ(synthetic queries)」と呼んでいます。人が打った検索語とは別に、AIが自分で作る検索語です。
どんな検索を作るのかは、Googleの別の特許がヒントになります。生成モデルで検索の「変種」を作る仕組みについての特許で、作る検索の種類が8つ挙げられています(Google Patents)。
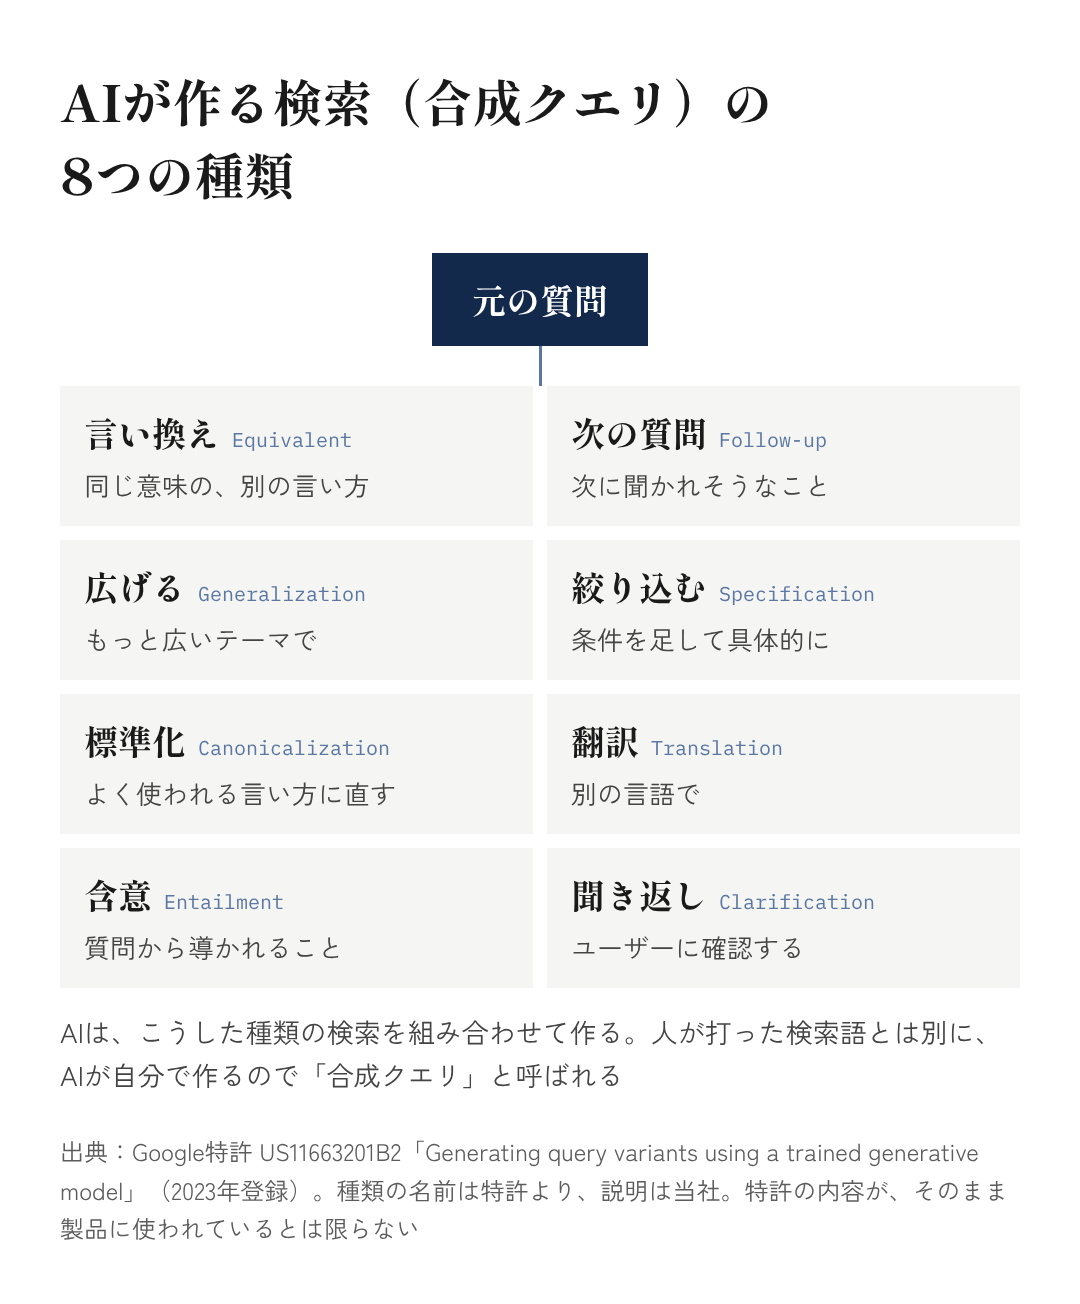
図1の給与計算ソフトの例でいえば、「3製品を比較」は条件を足して具体的にした検索、「パートナー制度」は次に聞かれそうなことを先回りした検索に見えます。特許に書かれていることがそのまま製品に入っているとは限りませんが、AIがいろいろな角度から検索を作っている様子は、実例ともよく合っています。
3. それぞれ検索して、ページを集める
作った検索を実行し、それぞれで上位に出てくるページを集めます。ここで使われているのは、GoogleやBingなど、いつもの検索エンジンです(次の章で詳しく書きます)。何本もの検索の結果は、ひとつの候補リストにまとめられます。
4. 読み合わせて、答えを組み立てる
最後に、集めたページを読み合わせて答えを書き、根拠にしたページを引用元として示します。
従来の検索と比べると、これまでは人が検索語を考え、人がリンクを開いて読み比べていました。いまは、検索語を考えるのも、読み比べるのも、AIです。
AIが答えを組み立てる流れと、AIの答えに名前が挙がる会社の条件は、ホワイトペーパーにも1冊にまとめています。
AIは、どの検索エンジンの結果を使っているのか
3つ目の段階で、AIは何を検索しているのか。「結局、検索結果を見ているの?」と思った方もいると思います。検索するときは、そのとおりです。 AIは、作った検索をいつもの検索エンジンにかけ、上位に出てきたページを中心に開いて読んでいます。
どの検索エンジンを使っているかは、サービスによって違います。
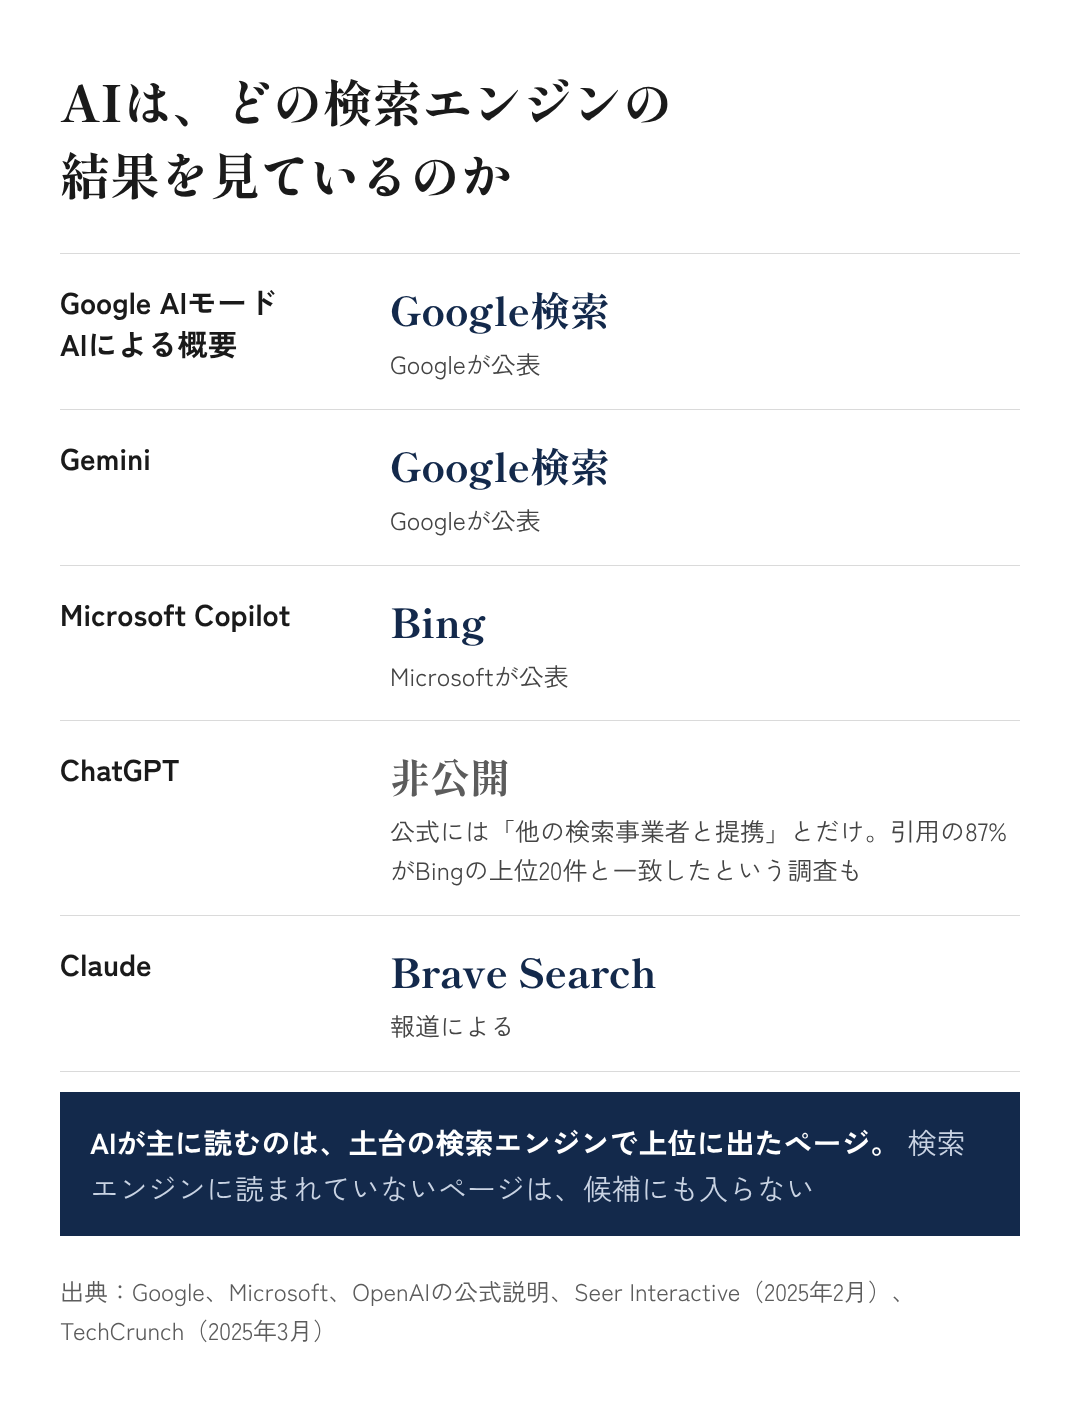
Googleは、AIモードの検索でGoogle検索を使うことを公表しています(Google)。MicrosoftのCopilotは、Bingの検索結果をもとに答えを作ると説明しています(Microsoft)。
ChatGPTは、どこの検索を使っているかを明かしていません。OpenAIのヘルプには「他の検索事業者と提携することもある」とだけ書かれています(OpenAI)。ただ、Seer Interactiveが約100問で調べたところ、ChatGPTの引用の87%がBingの上位20件と一致し、Googleとの一致は56%でした(Seer Interactive)。ChatGPTの検索結果に出るには、OpenAIの検索用クローラー「OAI-SearchBot」がサイトを読める状態にしておく必要もあります(OpenAI)。ClaudeはBrave Searchを使っていると、2025年3月に報じられています(TechCrunch)。
引用されるページは、元の質問より、広げた検索で上位にいる
では、元の質問で検索上位にいるページが、そのままAIに引用されるのか。ここが、クエリ・ファンアウトのいちばん面白いところです。
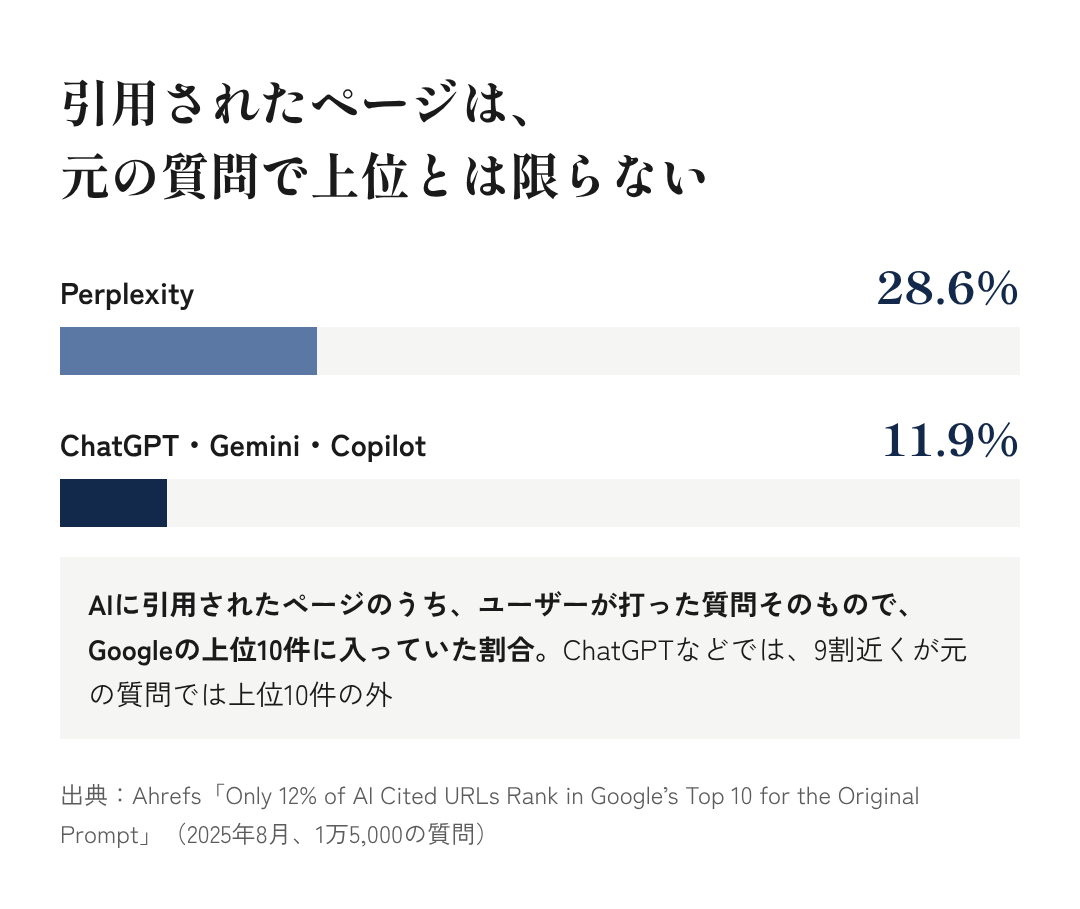
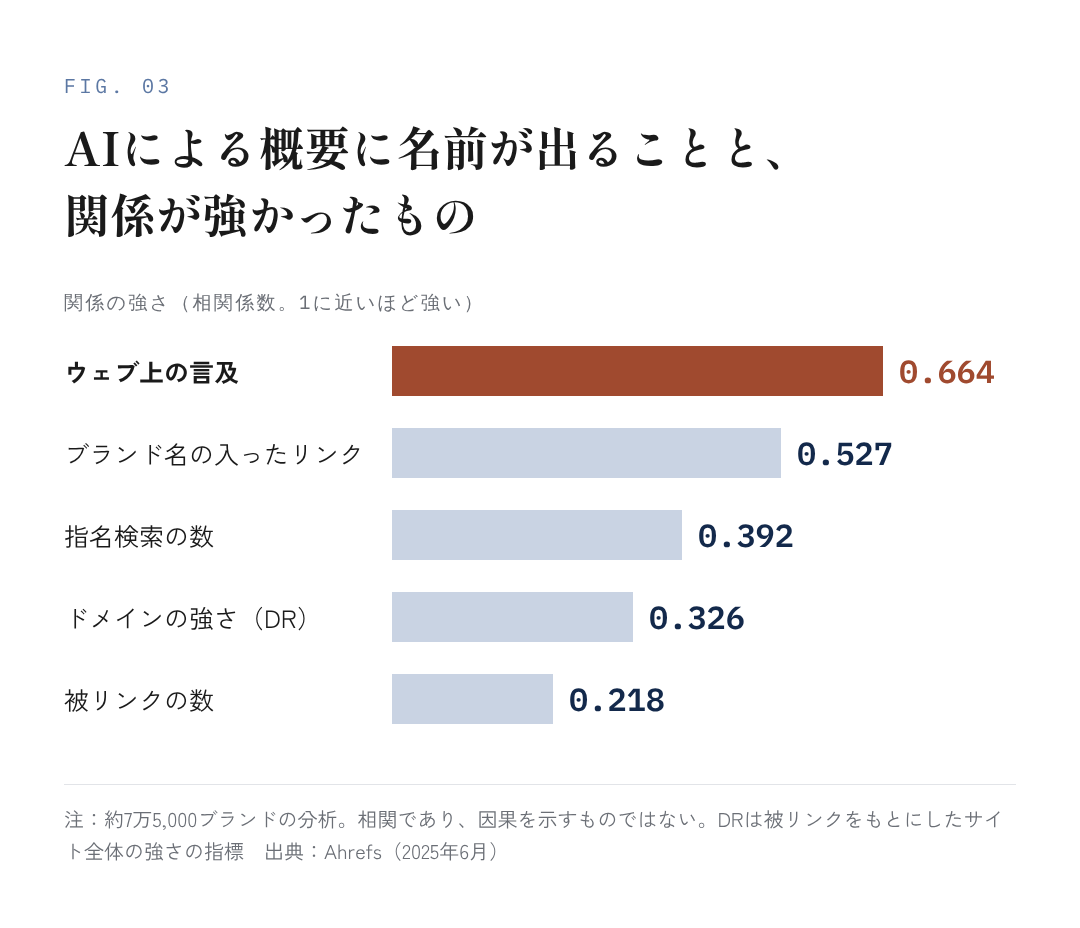
Ahrefsが1万5,000の質問で調べたところ、ChatGPT、Gemini、Copilotが引用したページのうち、ユーザーが打った質問そのものでGoogleの上位10件に入っていたのは、約12%だけでした。Perplexityでも28.6%です(Ahrefs)。Ahrefsは、この理由にクエリ・ファンアウトを挙げています。AIは元の質問をそのまま検索するとは限らず、広げた検索のほうで出てきたページを読んでいる、ということです。
では、広げた検索のほうの順位はどうなのか。これを調べたのがSurferです。1万のキーワードについて、元の検索と、Geminiで推定した「広げた検索」の両方で上位10件を集め、Googleの「AIによる概要」に引用されたページと突き合わせています(Surfer)。
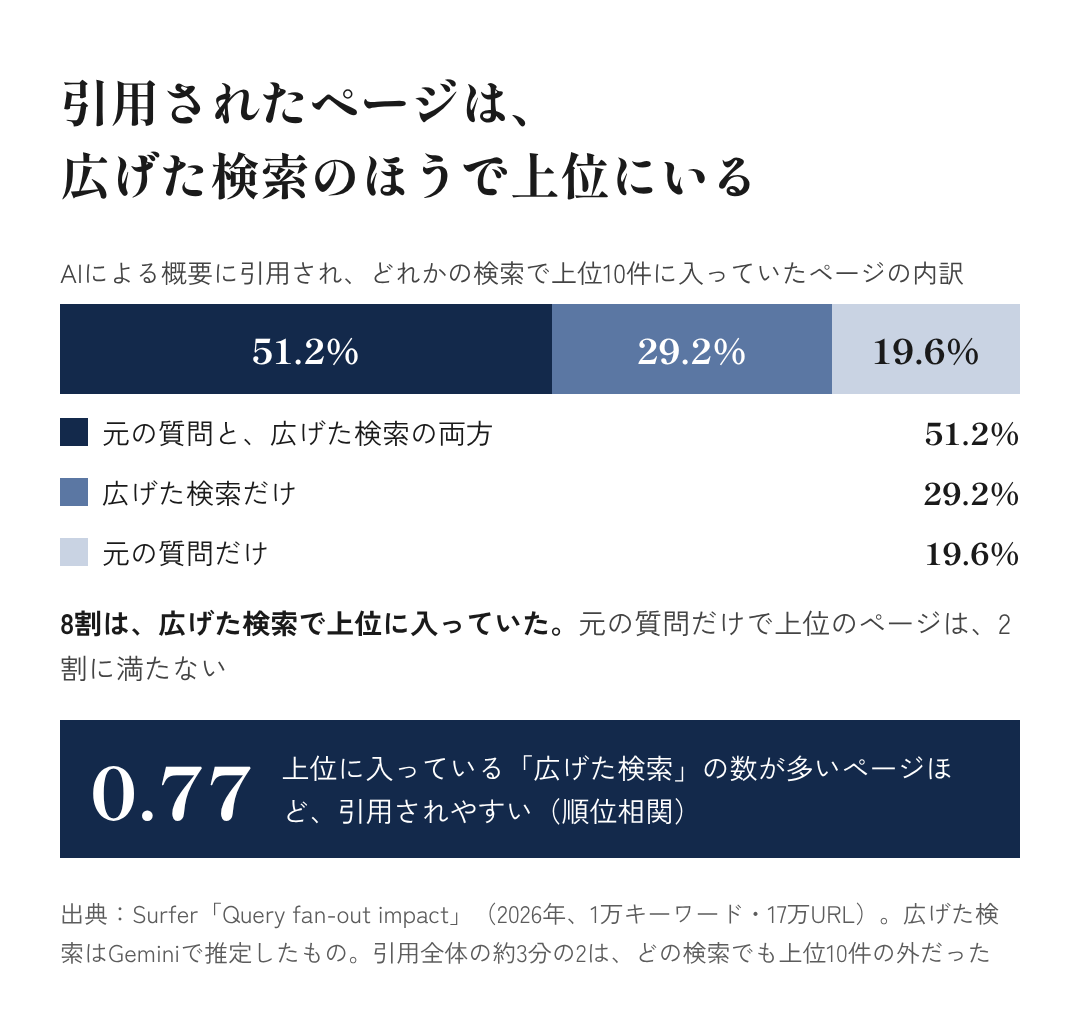
どれかの検索で上位10件に入っていた引用ページのうち、8割は、広げた検索で上位に入っていました。 元の質問だけで上位だったページは19.6%です。さらに、上位に入っている「広げた検索」の数と、引用されることのあいだには、0.77という強い順位相関がありました。ひとつの検索で強いページより、いくつもの検索に顔を出すページのほうが、引用されやすいということです。
ただし、引用されたページの約3分の2は、どの検索でも上位10件には入っていませんでした。11位以下のページや、検索結果に出てこないページも引用されているということで、順位がすべてではありません。Surfer自身も、相関であって因果ではない、と断っています。
いくつもの検索に出てくるページが強くなる理由は、3つ目の段階で、何本もの検索の結果をひとつの候補リストにまとめるときの方法で説明できそうです。Ahrefsが挙げている「RRF」という代表的な方法では、ひとつの検索で1位のページより、いくつもの検索で6位のページのほうが上にきます。
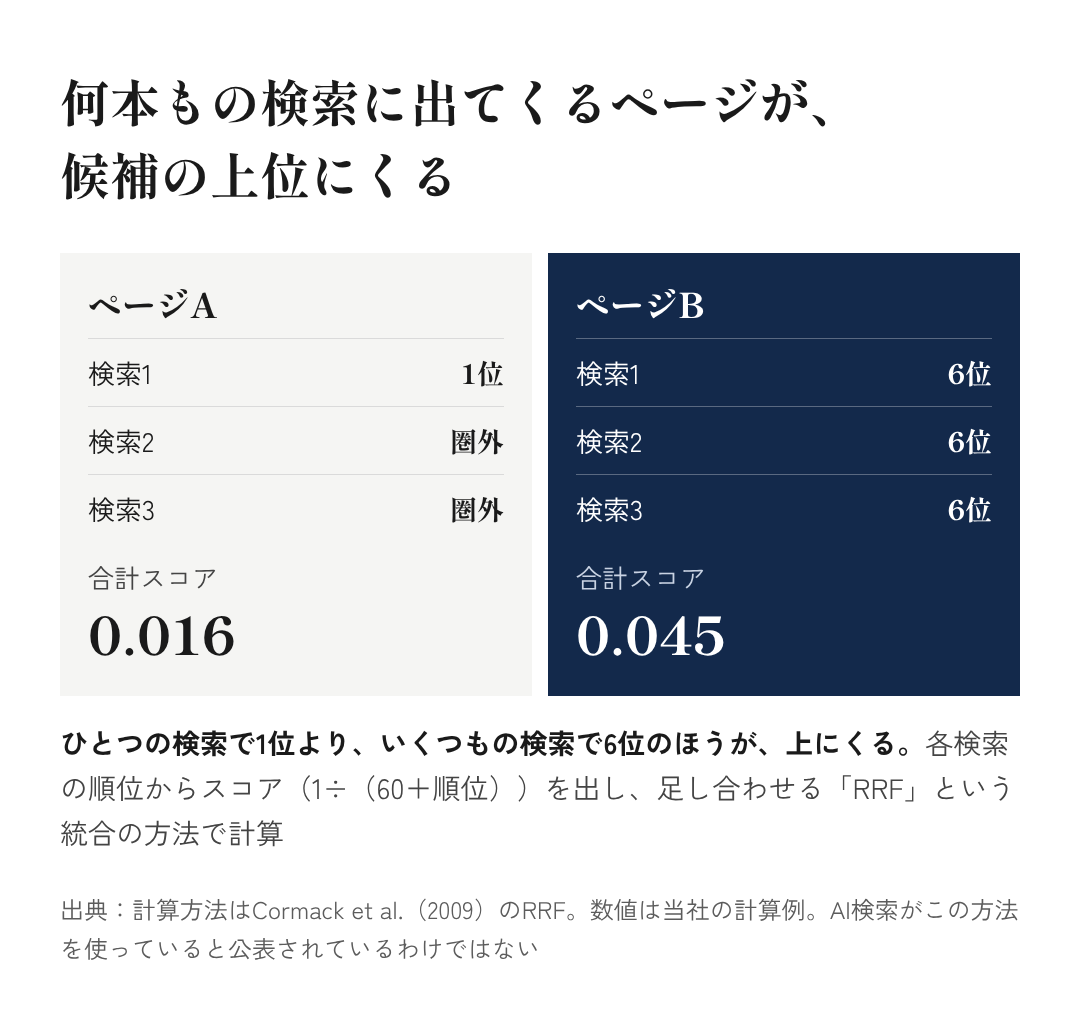
AI検索がこの方法を使っていると公表されているわけではありません。ただ、Surferの結果とは矛盾しません。
クエリ・ファンアウトのもとになった2つの研究
ここまで見てきたクエリ・ファンアウトは、突然出てきたアイデアではありません。検索と言語モデルの研究の中で、何年もかけて形になってきたものです。
ひとつは「質問を分解する」研究です。2022年に発表された「Self-Ask」という手法では、言語モデルが元の質問に答える前に、自分で追加の質問を立て、それにひとつずつ答えていきます。その追加の質問を検索エンジンに投げると、正確さが上がることが示されました(Press et al., 2022)。
もうひとつは「検索語を広げる」研究です。Googleの研究者らによる2023年の論文では、言語モデルに検索語を広げさせると、従来の拡張の手法より検索の精度が上がること、そして「考える過程を書かせる」指示が特に効くことが報告されています(Jagerman et al., 2023)。
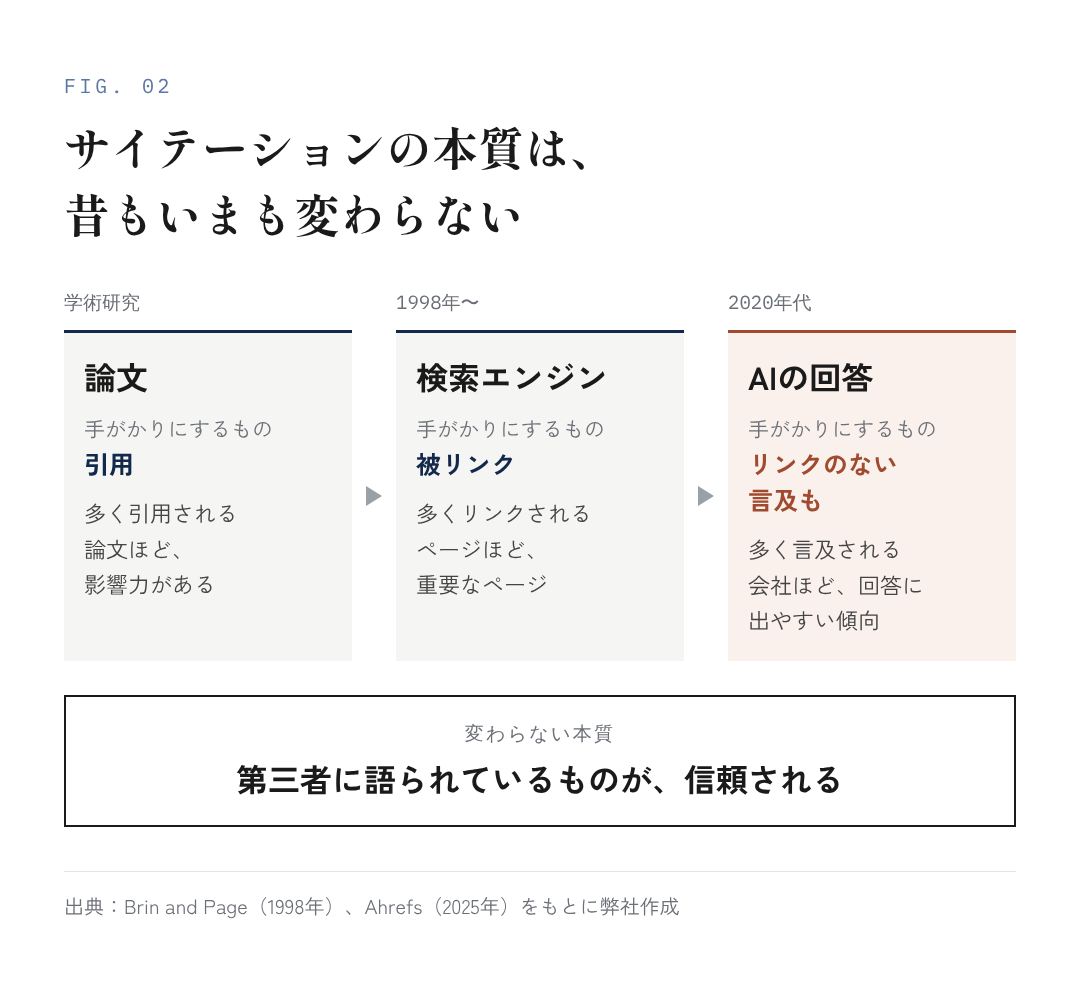
質問を分解し、検索語を広げ、集めた結果から答える。 この2つの流れが合流し、検索サービスに実装されたものが、いまのクエリ・ファンアウトだと捉えるとわかりやすいと思います。
AIがひとつの質問から作る検索の数と中身
では、いまのAIは、ひとつの質問から実際にいくつの検索を作っているのか。海外では、すでに計測が始まっています。
Seer Interactiveが501個の質問をGemini 3に投げて調べたところ、ひとつの質問から作られる検索は平均10.7本、多いものでは28本でした。前の世代のGemini 2.5は平均6.01本だったので、モデルが新しくなって8割近く増えています(Seer Interactive)。
ChatGPTはもう少し控えめです。2,000万件以上の検索を分析したPeec AIの調査では、ひとつの質問あたり2.3〜2.8本でした。ただ、1本あたりの検索語は、2025年10月の約6語から、2026年1月には約12語へと長くなっています(Peec AI)。本数は少なくても、1本1本がどんどん長く、具体的になっているようです。
中身を見ると、さらに興味深いことがわかります。
Gemini 3が作った検索のうち、95%は検索ボリュームがゼロで、ほかの質問から作られた検索と重なるものは約1%。2割には年が、4分の1にはブランド名が入っていました(いずれもSeer InteractiveのGemini 3の調査)。
自社に関わる質問を、AIがどう広げて調べ、どう答えているのか。それは実際に聞いてみないとわかりません。確かめ方は、AI検索診断のご案内にまとめています。
クエリ・ファンアウトからわかる、AIに引用されるための3つの条件
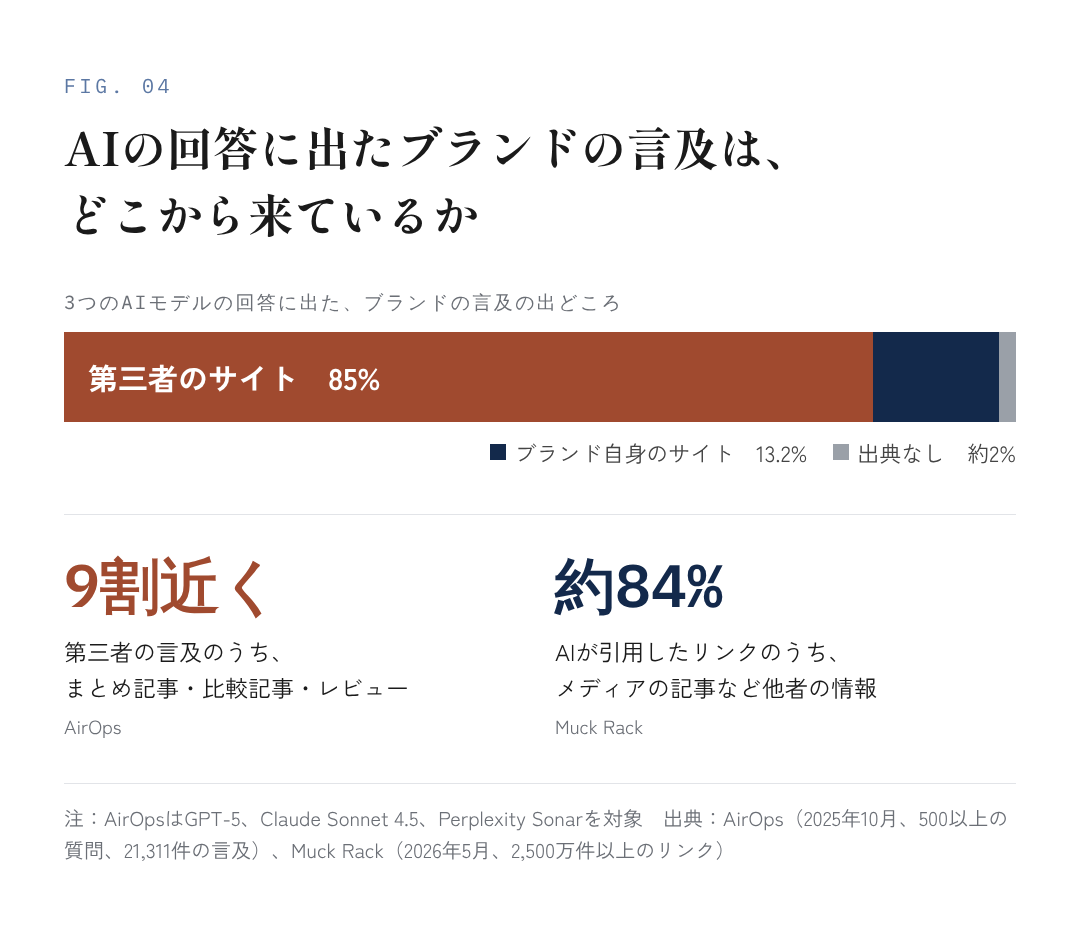
ここまでの仕組みと数字から、企業にとって大事なことが3つ見えてきます。まず、AI検索でも、検索エンジンでの順位は効いています。 ただし、効いているのは元の質問での順位より、AIが広げた検索での順位です。広げた検索は長くて具体的で、ほとんどは検索ボリュームがゼロです。キーワード調査で見つけて1語ずつ狙う、という従来のやり方では追いきれません。追えるのは、「その質問を広げると、どんな問いになるか」のほうです。誰が、どんな場面で、何と比べて、いくらで。そうした具体的な問いに正面から答えるページがあれば、広げた検索のどれかで上位に出る可能性が上がります。
次に、いくつもの検索で拾われるページが強くなります。 弊社のAI検索診断にも、これに近いデータがあります。同じカテゴリーで競合する2社の比較です。そのサービスの専用ページを持つA社は、推薦の質問の88.9%で名前が挙がりました。サービス一覧に一行書いただけのB社は、0%でした。B社が劣っていたわけではありません。広げた検索のどれに対しても、B社には答えになるページがなかった。差が出た理由は、ここにあると考えています。
そして、AIは書いてあることしか使いません。 人なら「この会社ならたぶんできる」と行間を読んでくれますが、AIが根拠にできるのは、どこかに書かれていることだけです。2割の検索に年が入っているのは、新しい情報を探しているからでしょう。年や更新日が書かれていないページは、こうした検索では根拠に使われにくいはずです。4分の1の検索にブランド名が入っているということは、その会社の名前で検索して出てくる比較サイトや記事も、AIは読むことになります。
企業は、何をすればいいのか
この3つの条件を踏まえて、企業は何をすればいいのか。具体的な進め方は、AIO対策の記事で詳しく書いています。ここでは方向だけ。
- 検索エンジンに読まれる状態を保つ:インデックスされているか、AIの検索用クローラーを拒否していないか
- 広がった先の問いに、ひとつずつ答えるページを持つ:誰の、どんな場面の、どんな悩みに、どう応えるのか。総合ページ1枚では、広げた検索のどれでも決め手になりにくい
- 日付と事実をはっきり書く:料金、対象、実績、更新日。数字や日付が書いてあれば、AIはそれを根拠に使えます
- 自社サイトの外でも語られる:ブランド名で検索したときに出てくる比較サイトや業界メディアも、AIは読んでいます
クエリ・ファンアウトを知ると、AI検索で問われているのは小手先の技術より、「自分たちは誰の、どんな問いに答えられる会社なのか」を言葉にできているかどうかだとわかります。前回のサイトづくりの話と同じで、ここでも強いのは、言語化できている会社なんだと思います。
参考:Google AI Mode(Google)/ChatGPT search(OpenAI)/Microsoft「The new Bing: Our approach to Responsible AI」/TechCrunch「Anthropic appears to be using Brave to power web searches for its Claude chatbot」(2025年3月)/Google Patents「US11663201B2 Generating query variants using a trained generative model」/Seer Interactive「87% of SearchGPT Citations Match Bing's Top Results」(2025年2月)/Ahrefs「Only 12% of AI Cited URLs Rank in Google's Top 10 for the Original Prompt」(2025年8月)/Surfer「Query fan-out impact」(2026年)/Google「Grounding with Google Search」/Mallen et al.「When Not to Trust Language Models」(2023)/cloro「ChatGPT Grounding Study」(2026年8月)/Google Patents「US20240289407A1 Search with stateful chat」/OpenAI「Overview of OpenAI Crawlers」/Press et al.「Measuring and Narrowing the Compositionality Gap in Language Models」(2022)/Jagerman et al.「Query Expansion by Prompting Large Language Models」(2023)/Seer Interactive「Gemini 3 Query Fan-Outs Research」(2025年11月)/Peec AI「ChatGPT fan-outs have doubled in length in 4 months」/Cormack et al.「Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods」(2009)
 WRITTEN BY佐藤 大貴アースダイバー株式会社 代表取締役DeNAで男性向けライフスタイルメディアの立ち上げを牽引し、ローンチから約1年半で月間3,000万PV規模に。ポートではコンテンツマーケティング責任者として幅広い領域のメディアを管掌し、上場とM&Aを経験。2019年に創業し、AI時代のマーケティング戦略とその実行を手がける。プロフィールを見る →LinkedIn